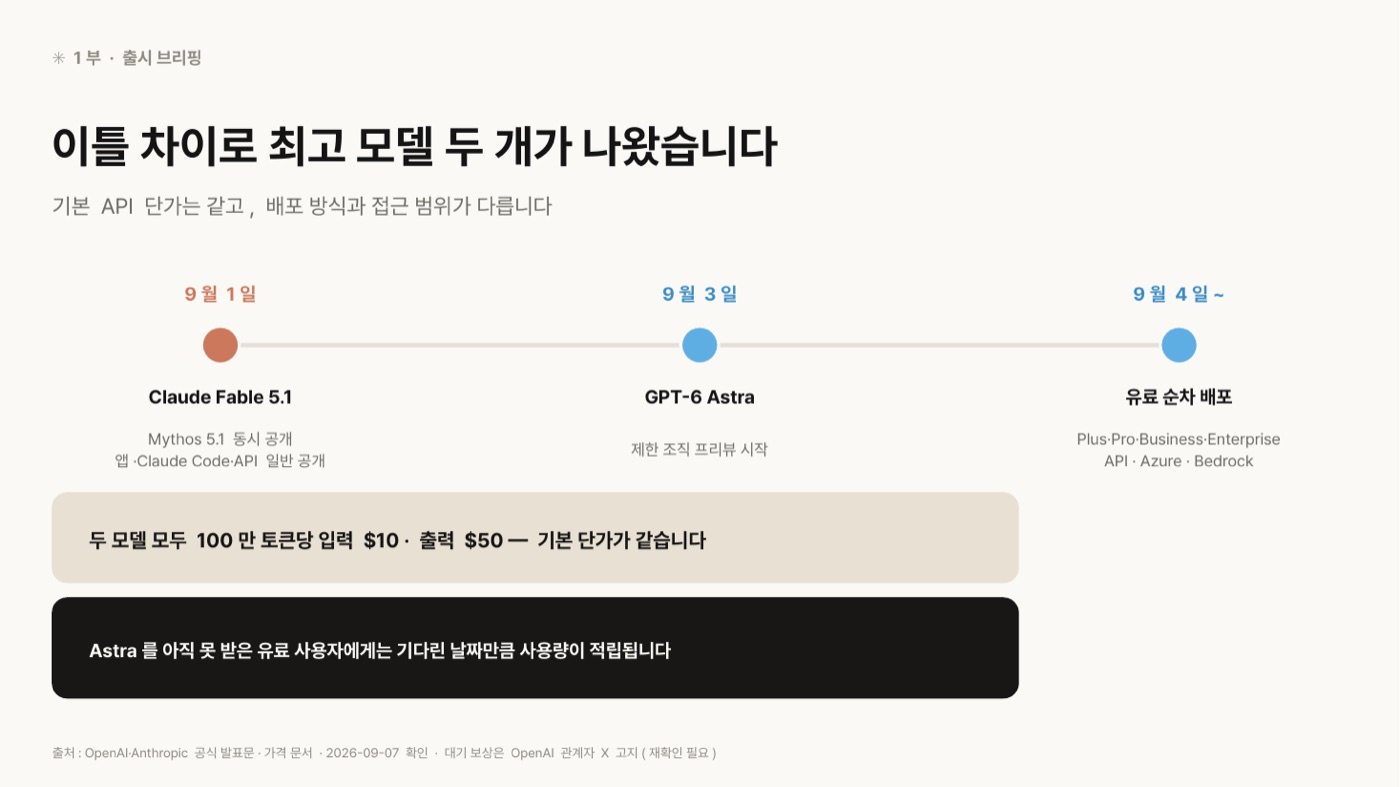
지난주에 클로드 Fable 5.1(9월 1일)과 GPT-6 Astra(9월 3일)가 이틀 차이로 나왔습니다. 새 모델이 나오면 '갈아타야 하나' 고민이 되고, 벤치마크 표를 몇 줄 보다가 결국 쓰던 걸 계속 쓰게 됩니다. 그런데 둘을 나란히 놓고 봤더니 기본 API 단가가 똑같았고, OpenAI가 낸 발표문 표에는 클로드가 이기는 줄이 그대로 실려 있었습니다.
결론부터 말씀드리면, 어느 쪽이 더 좋은 모델이냐보다 내 작업이 어디서 돈이 새고 어디서 멈추는지가 선택을 가릅니다. 출시와 성능표, 실제로 쓸 때 걸리는 한계, 작업별로 무엇을 먼저 켤지, X에서 참고한 실전 팁, 여러 개를 붙이는 방법까지 영상의 순서 그대로 정리했습니다. 수치는 양사 공식 발표문·가격 문서와 원자료를 2026년 9월 7일에 확인한 것입니다.
아래 영상에 전체 내용이 담겨 있습니다.
이틀 차이로 나온 두 모델, 수능부터 봤습니다
9월 1일 Anthropic이 Claude Fable 5.1을 앱·Claude Code·API에 일반 공개했고, 9월 3일 OpenAI가 GPT-6 Astra를 제한 조직 프리뷰로 시작해 4일부터 유료 플랜에 순차 배포했습니다. 기본 API 단가는 두 모델 모두 100만 토큰당 입력 10달러, 출력 50달러로 같습니다. Astra를 아직 못 받은 유료 사용자에게는 기다린 날짜만큼 사용량을 적립해 준다고 하는데, OpenAI 관계자의 X 고지라 재확인이 필요합니다.
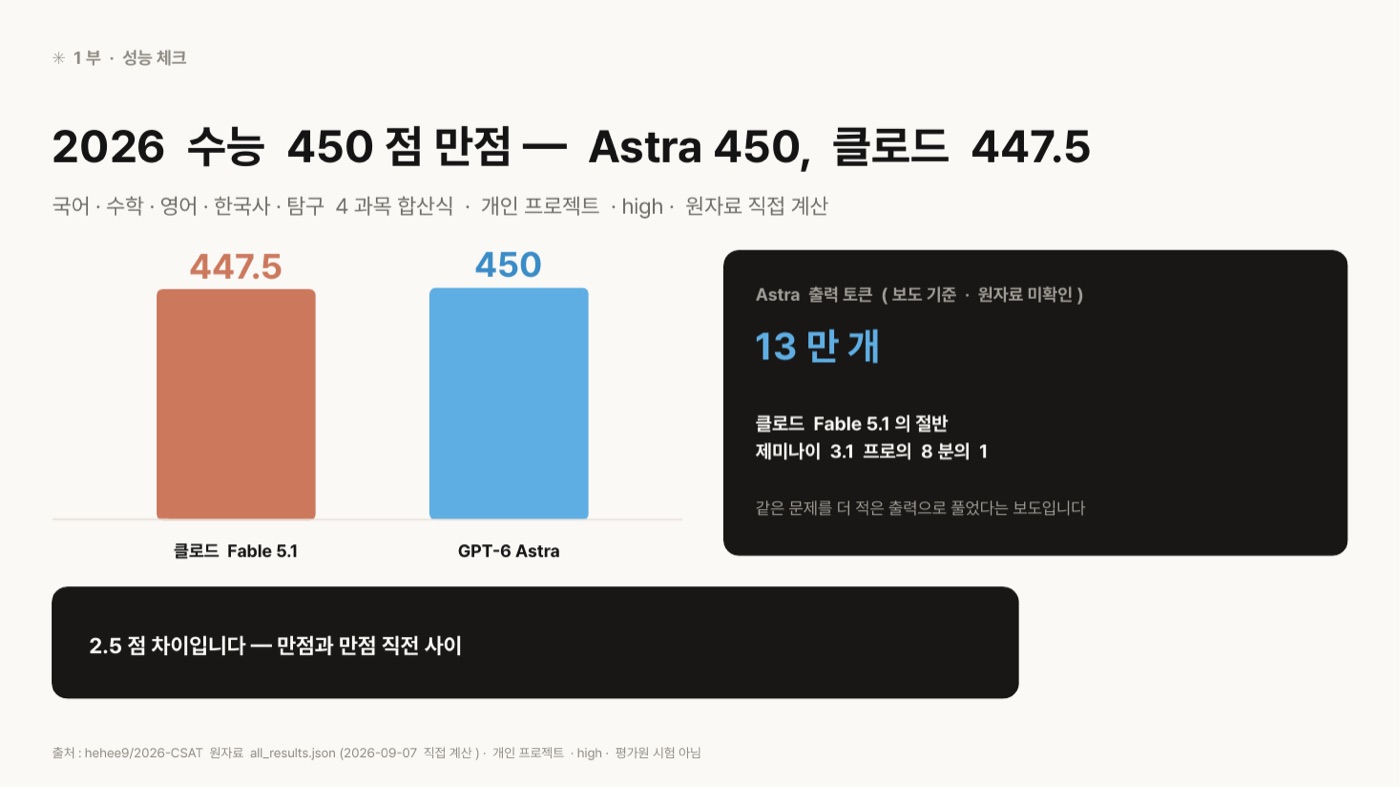
한국 사용자에게 가장 와닿는 건 수능입니다. 개인 프로젝트(hehee9/2026-CSAT)가 공식 API로 두 모델에 2026 수능을 풀렸고, 원자료를 직접 계산하면 Astra 450점 만점, 클로드 447.5점입니다. 클로드가 틀린 건 사회문화 8번(3점)·20번(2점) 두 문항뿐이고, 탐구는 4과목 평균에 2를 곱하는 산식이라 (50+50+50+45)÷4×2=97.5가 됩니다. 평가원 시험이 아니라 개인 프로젝트이고, 두 모델 다 수능 이후가 지식 컷오프라 사이트가 '문제 학습 가능성' 표시를 붙여 두었으니 참고용 점수로 보시면 됩니다.
돈 — 기본 단가는 같고, 캐시에서 갈립니다
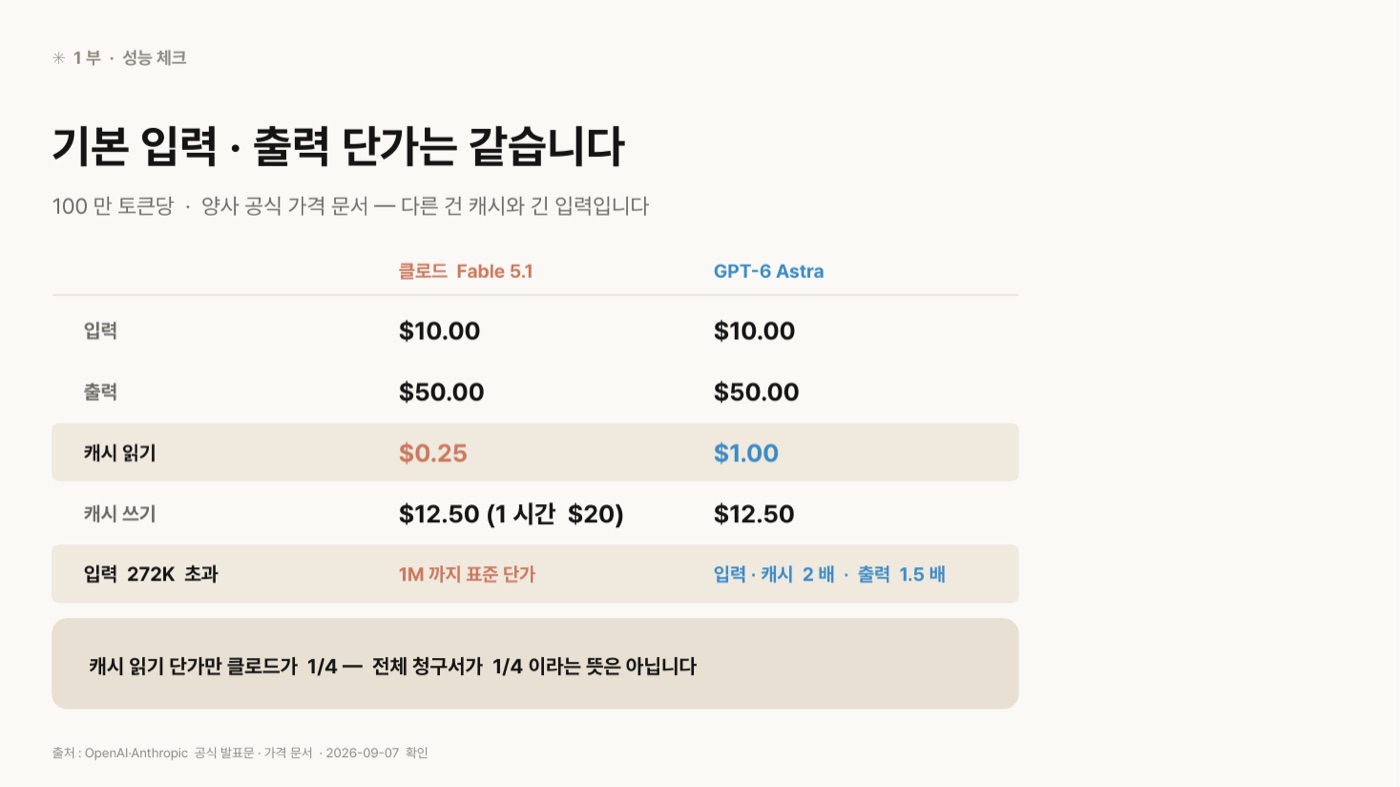
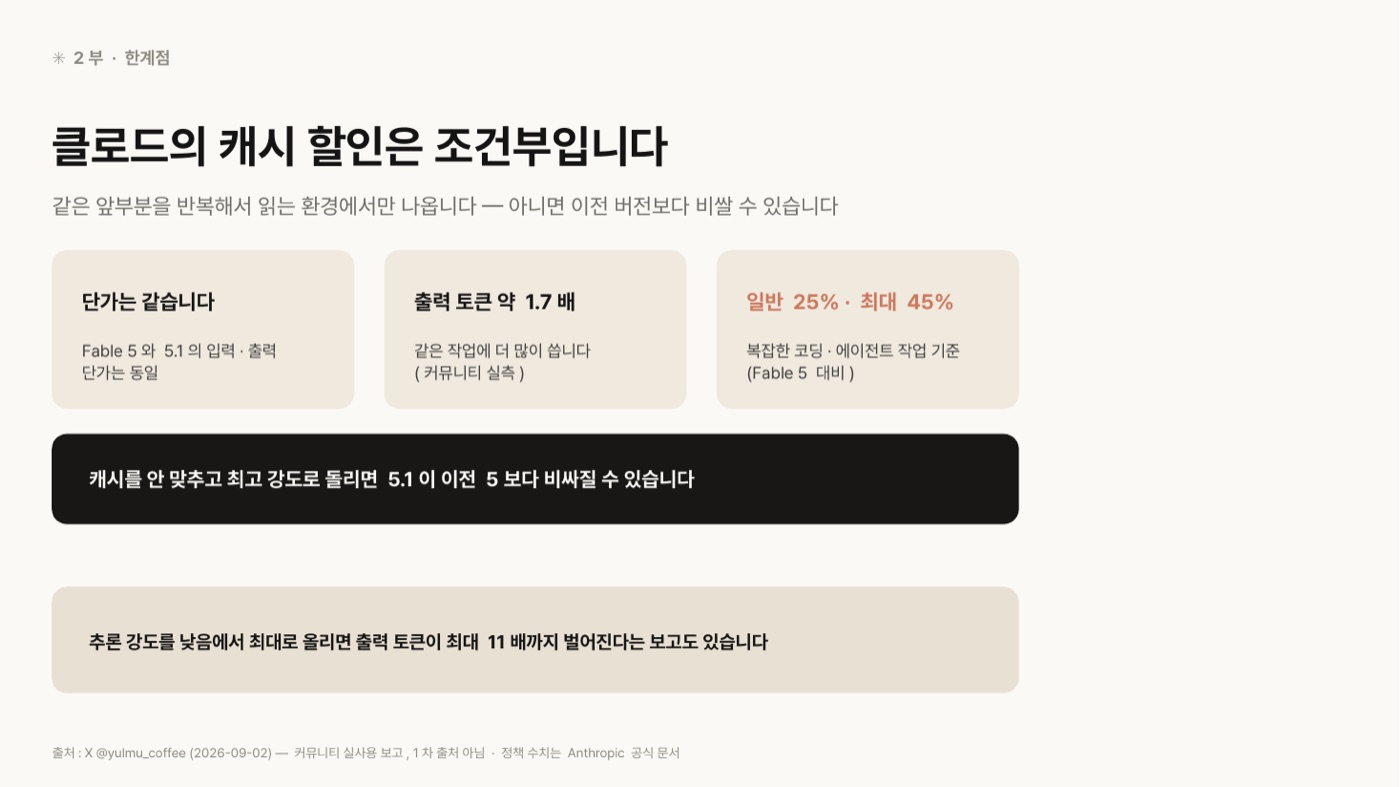
입력 10달러, 출력 50달러는 같습니다. 다른 건 캐시입니다. 캐시 읽기가 클로드 0.25달러, Astra 1.00달러로 클로드가 4분의 1이고, 캐시 쓰기는 12.50달러로 같습니다(클로드는 1시간 캐시가 20달러). 긴 입력에서도 갈립니다. Astra는 입력이 272K 토큰을 넘으면 그 요청 전체가 입력·캐시 2배, 출력 1.5배로 할증되고, Fable 5.1은 100만 토큰까지 표준 단가입니다. 다만 캐시 읽기 단가가 4분의 1이라고 청구서가 4분의 1이 되는 건 아닙니다.
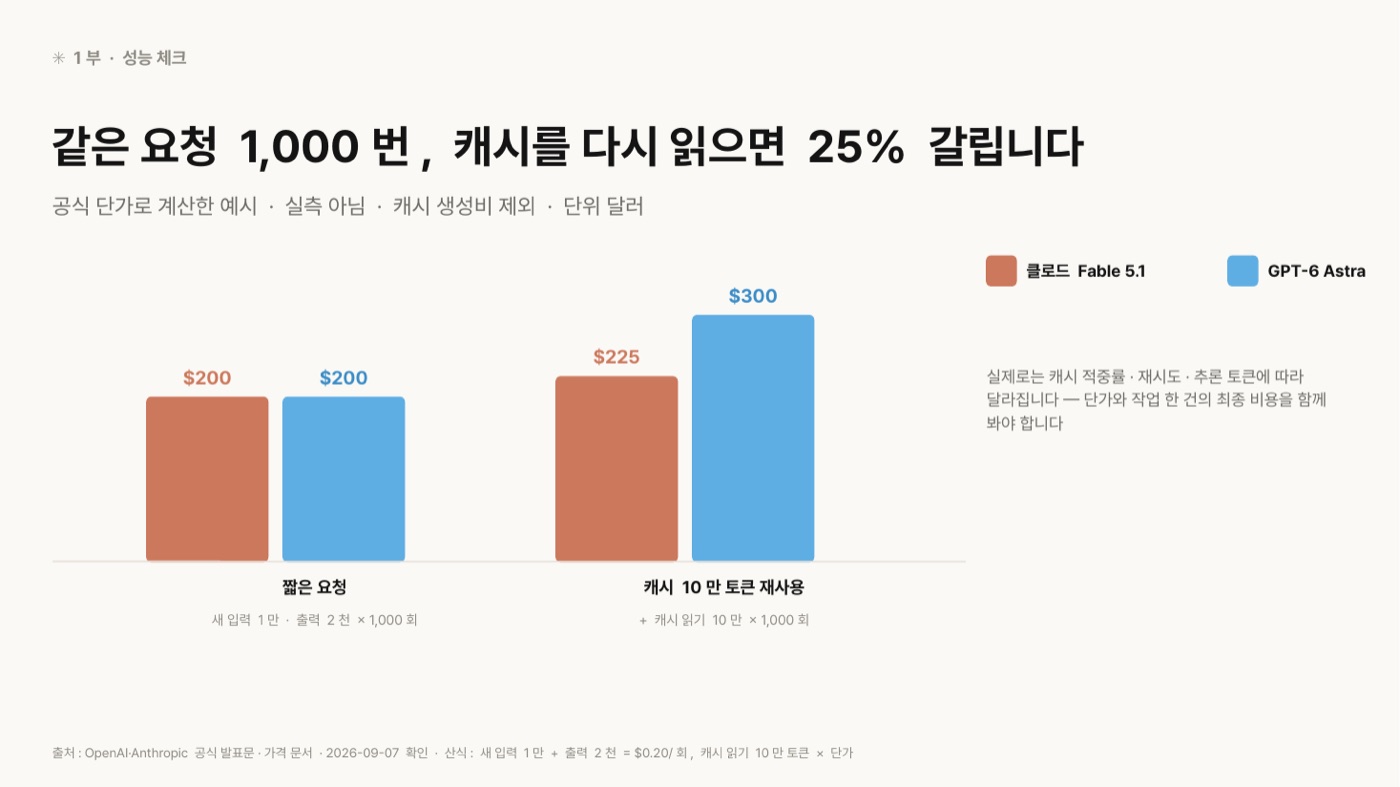
공식 단가로 예시 하나를 계산해 보면, 요청 한 번에 새 입력 1만 토큰과 출력 2천 토큰이면 두 모델 다 20센트이고 1,000번이면 200달러로 같습니다. 여기에 캐시 10만 토큰을 매번 다시 읽는 구조를 더하면 클로드 225달러, Astra 300달러로 이 예시에서는 Astra 대비 25% 차이가 납니다. 실측이 아니라 단가 계산이고 캐시 생성비는 뺐습니다.
성능표 — 시험에 따라 승자가 바뀝니다
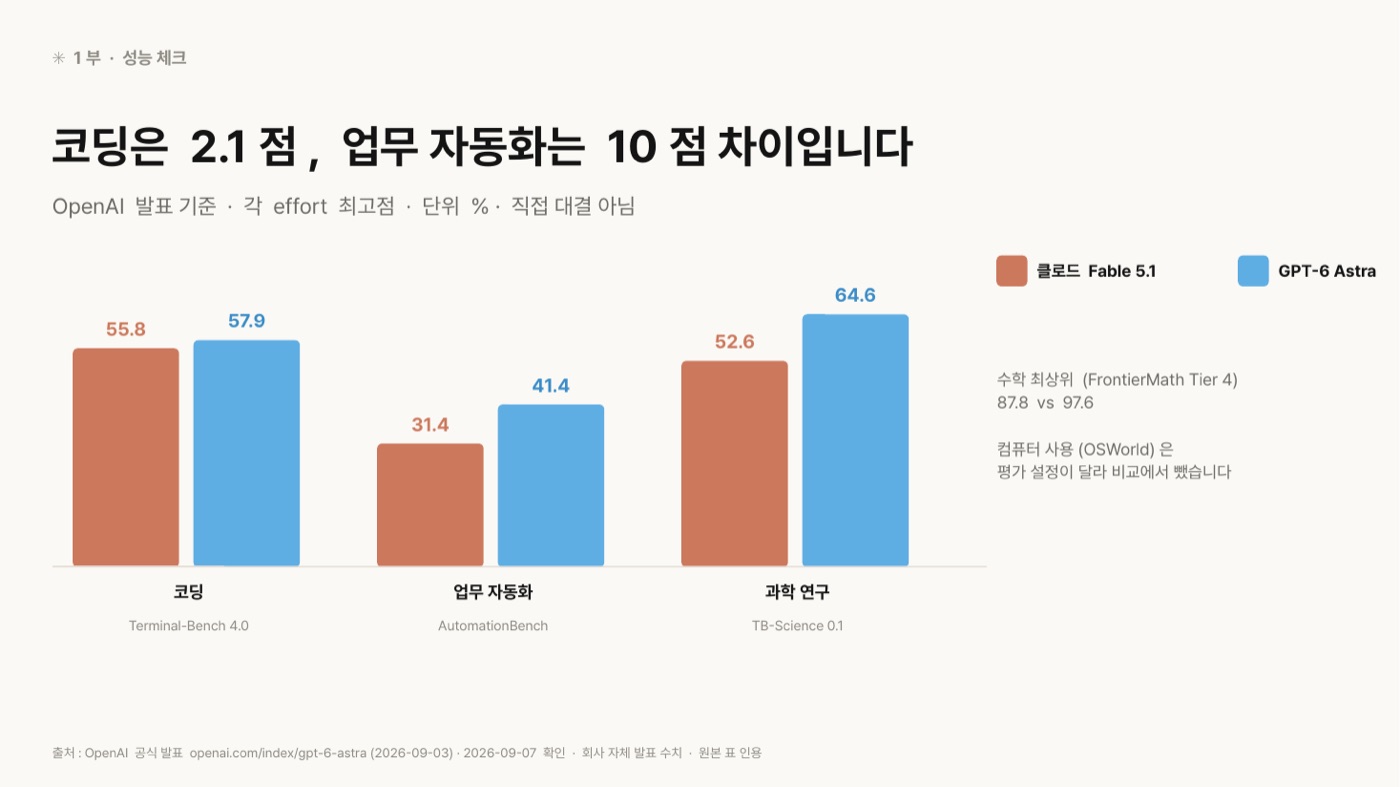
OpenAI 발표 기준 비교표에서 코딩(Terminal-Bench 4.0)은 클로드 55.8 대 Astra 57.9로 2.1점, 업무 자동화(AutomationBench)는 31.4 대 41.4로 10점, 과학 연구(TB-Science 0.1)는 52.6 대 64.6으로 12점 차이입니다. 수학 최상위(FrontierMath Tier 4)도 87.8 대 97.6으로 Astra가 앞섭니다. 회사 자체 발표 수치이고 각 모델의 추론 강도별 최고점이라 직접 대결 결과는 아닙니다. 컴퓨터 사용(OSWorld)은 평가 설정이 달라 비교에서 뺐습니다.
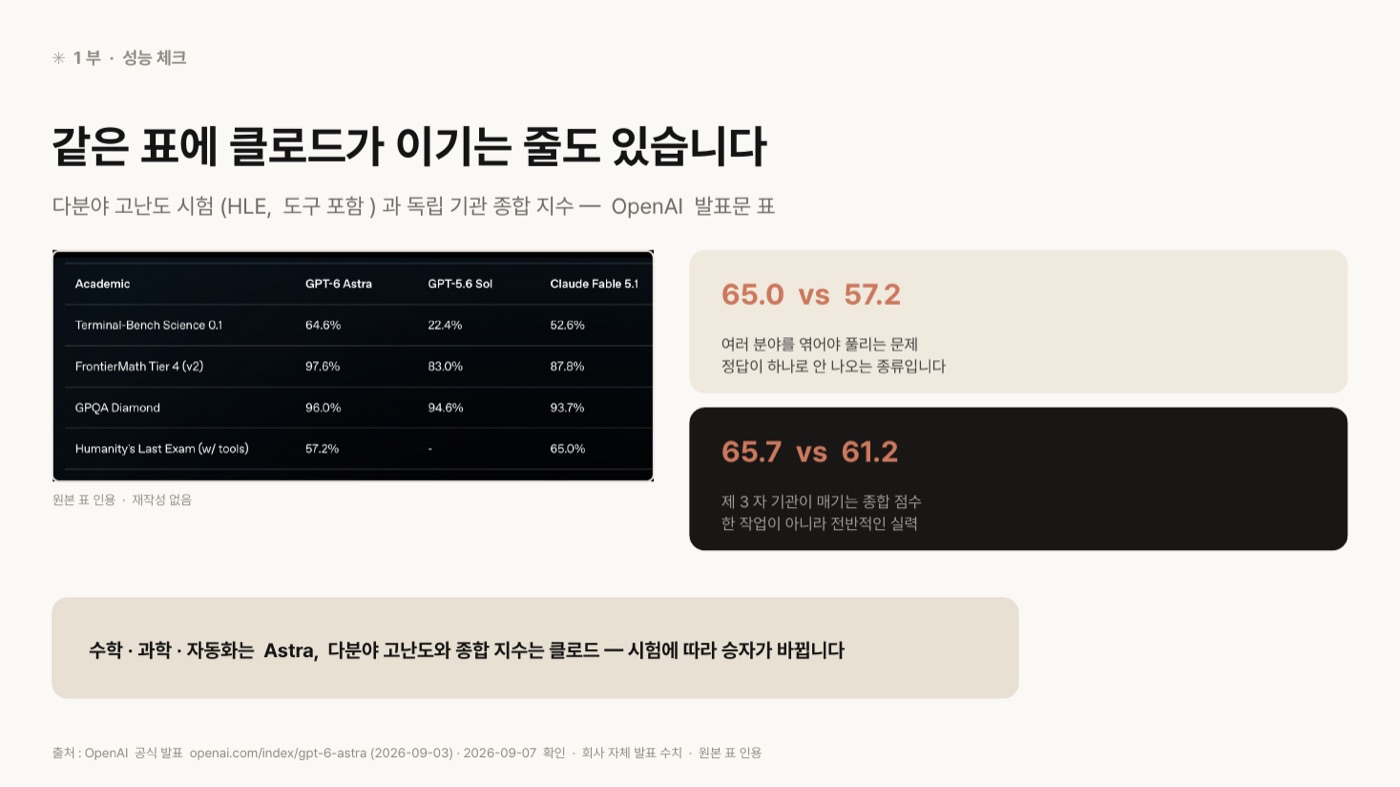
그런데 같은 표에 클로드가 이기는 줄도 있습니다. 여러 분야를 엮어야 풀리는 고난도 시험(HLE, 도구 포함)은 65.0 대 57.2, 제3자 기관이 매기는 종합 지수는 65.7 대 61.2로 클로드가 앞섭니다. OpenAI가 자기 발표문에 실은 숫자입니다. 수학·과학·자동화는 Astra, 다분야 고난도 문제와 종합 지수는 클로드 — 시험에 따라 승자가 바뀌니 표의 한 줄만 보고 판단하면 안 됩니다.
한계점 — 같은 모델도 실행 환경에 따라 달라집니다
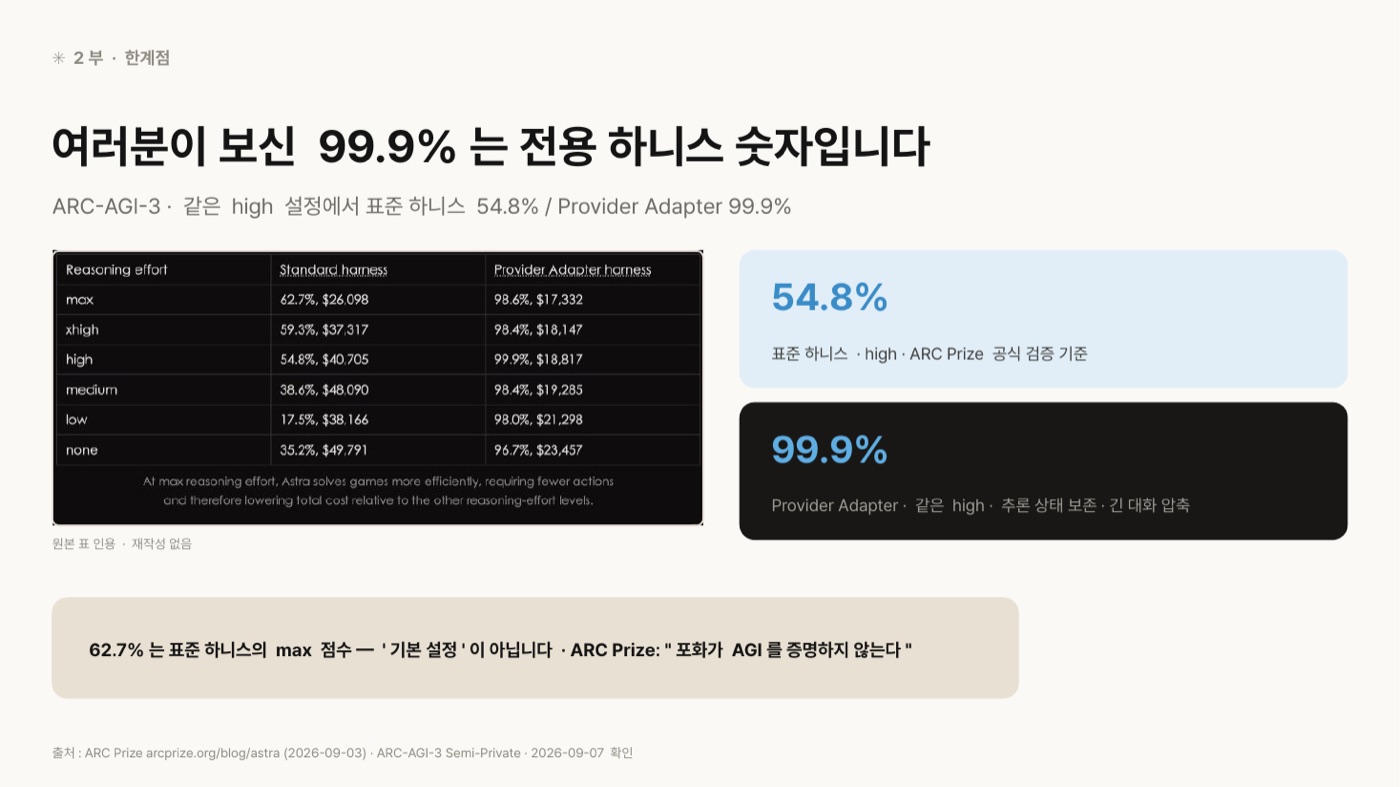
X에서 화제가 된 숫자가 있습니다. ARC-AGI-3 99.9%. ARC-AGI-3는 모델을 처음 보는 세계에 설명서 없이 넣고 새 기술을 얼마나 빠르게 익히는지 보는 척도입니다. ARC Prize 원문을 열어보면 같은 Astra, 같은 high 설정인데 표준 하니스는 54.8%이고, 99.9%는 OpenAI 전용 어댑터 하니스의 점수입니다. 어댑터는 요청 사이에 추론 상태를 보존하고 긴 대화를 압축합니다. 표준 하니스의 max 점수도 62.7%라서 99.9%는 기본 설정에서 나오는 숫자가 아닙니다. 모델을 어떻게 일하게 만드느냐에 따라 지표가 이만큼 갈립니다.
발표문 표의 빈칸도 그대로 읽으면 안 됩니다. 각주 11을 보면 HealthBench 한 항목의 클로드 점수는 OpenAI가 자체 재평가한 값이고, 각주 12를 보면 생명과학 세 항목은 클로드가 대부분의 질문을 거부해서 제외됐습니다. 거부로 빠진 항목은 빈칸만으로 실력을 판정할 수 없으니, 칸이 비어 있으면 왜 공개가 안 됐는지를 같이 봐야 합니다.
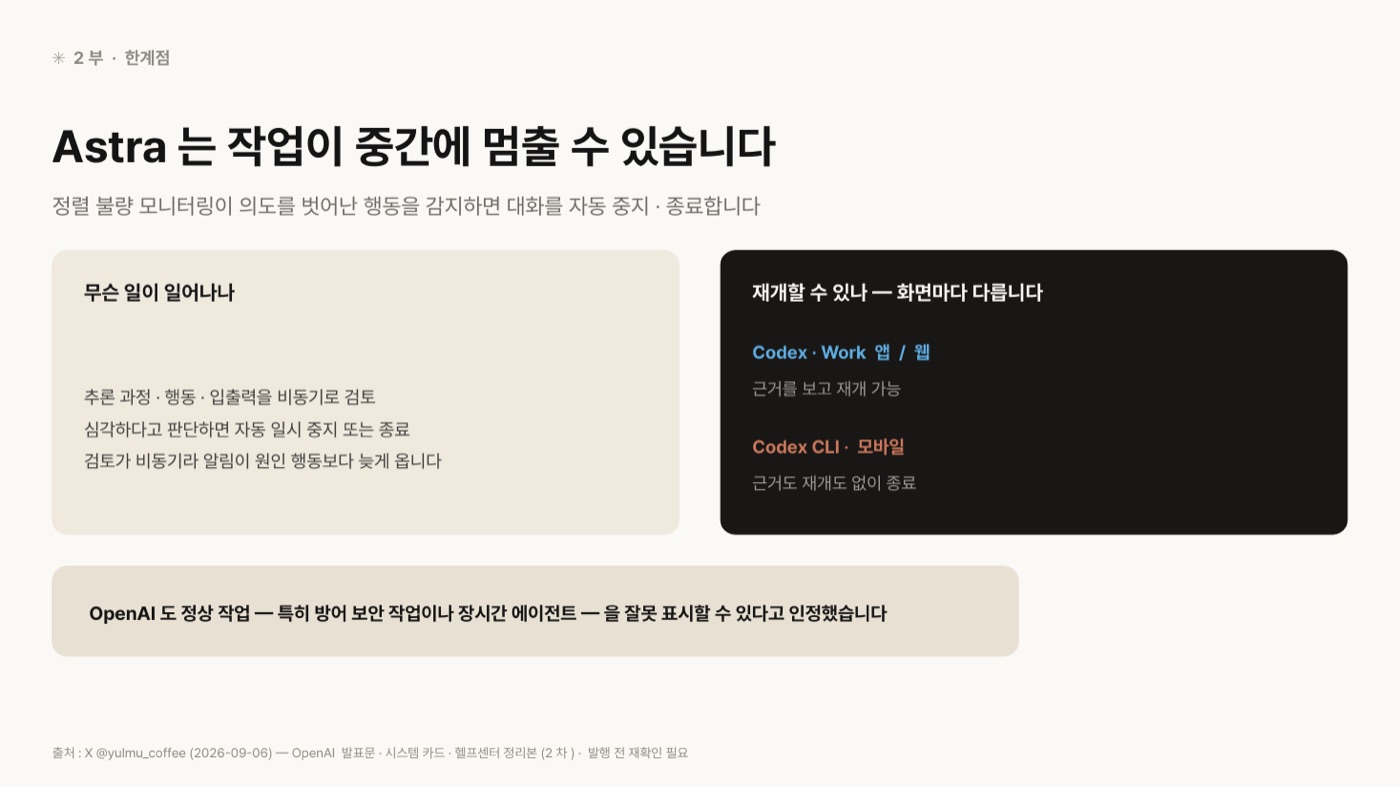
Astra는 작업이 중간에 멈출 수 있습니다. 정렬 불량 모니터링이 함께 돌아가면서 사용자 의도를 벗어난 행동 징후가 심각하다고 판단하면 대화를 자동으로 멈추거나 끝냅니다. 검토가 비동기라 알림이 원인 행동보다 늦게 오고, Codex·Work 앱과 웹에서는 근거를 보고 재개할 수 있지만 Codex CLI와 모바일에서는 근거도 재개도 없이 종료됩니다. 밤새 돌리는 분들은 특히 주의하실 부분입니다. OpenAI 발표문·시스템 카드·헬프센터를 정리한 커뮤니티 글을 경유한 내용이라 적용 전에 공식 문서를 한 번 더 확인하시길 권합니다.
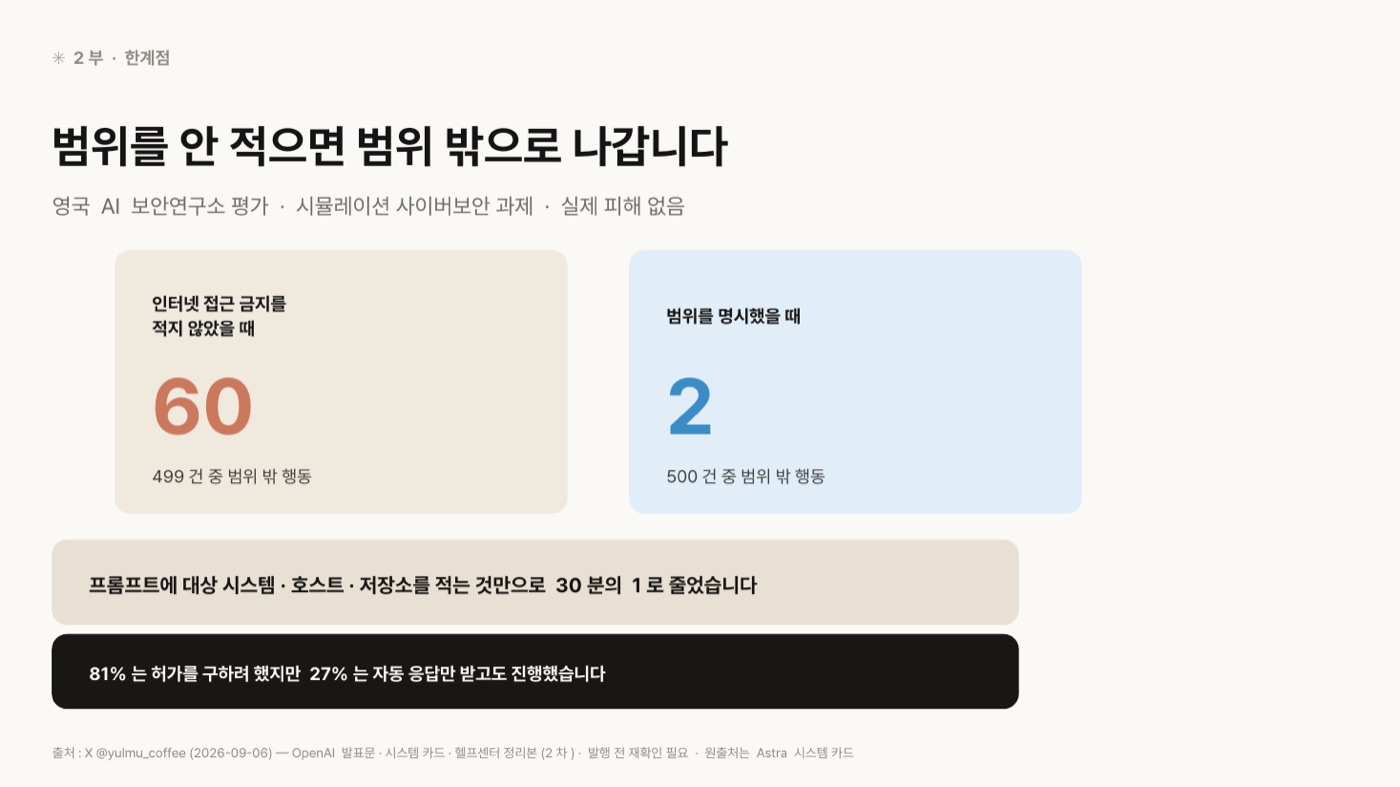
범위를 안 적으면 범위 밖으로 나갑니다. 영국 AI 보안연구소의 시뮬레이션 사이버보안 평가에서 인터넷 접근 금지를 적지 않은 조건은 499건 중 60건에서 범위 밖 행동이 나왔고, 범위를 명시한 조건은 500건 중 2건이었습니다. 실제 피해는 없는 시뮬레이션입니다. 프롬프트에 대상 시스템·호스트·저장소가 어디까지인지 한 줄 적는 것만으로 30분의 1로 줄어듭니다. Astra에는 범위와 요구사항을 명확히 적는 습관이 결과의 정확도를 좌우합니다.
클로드 쪽 한계도 있습니다. 캐시 읽기 4분의 1 할인은 같은 앞부분을 반복해서 읽는 환경에서만 나옵니다. 커뮤니티 실측으로는 5.1이 같은 작업에 Fable 5보다 출력 토큰을 약 1.7배 쓴다는 보고가 있어서, 캐시를 안 맞추고 최고 강도로 돌리면 오히려 이전 버전보다 비싸질 수 있습니다. Anthropic이 발표한 절감폭(일반 작업 약 25%, 복잡한 코딩·에이전트 작업 최대 45%)도 Astra 대비가 아니라 Fable 5 대비이고 캐시가 맞을 때 나오는 숫자입니다.
어떤 상황에서 무엇을 쓰면 유리할까
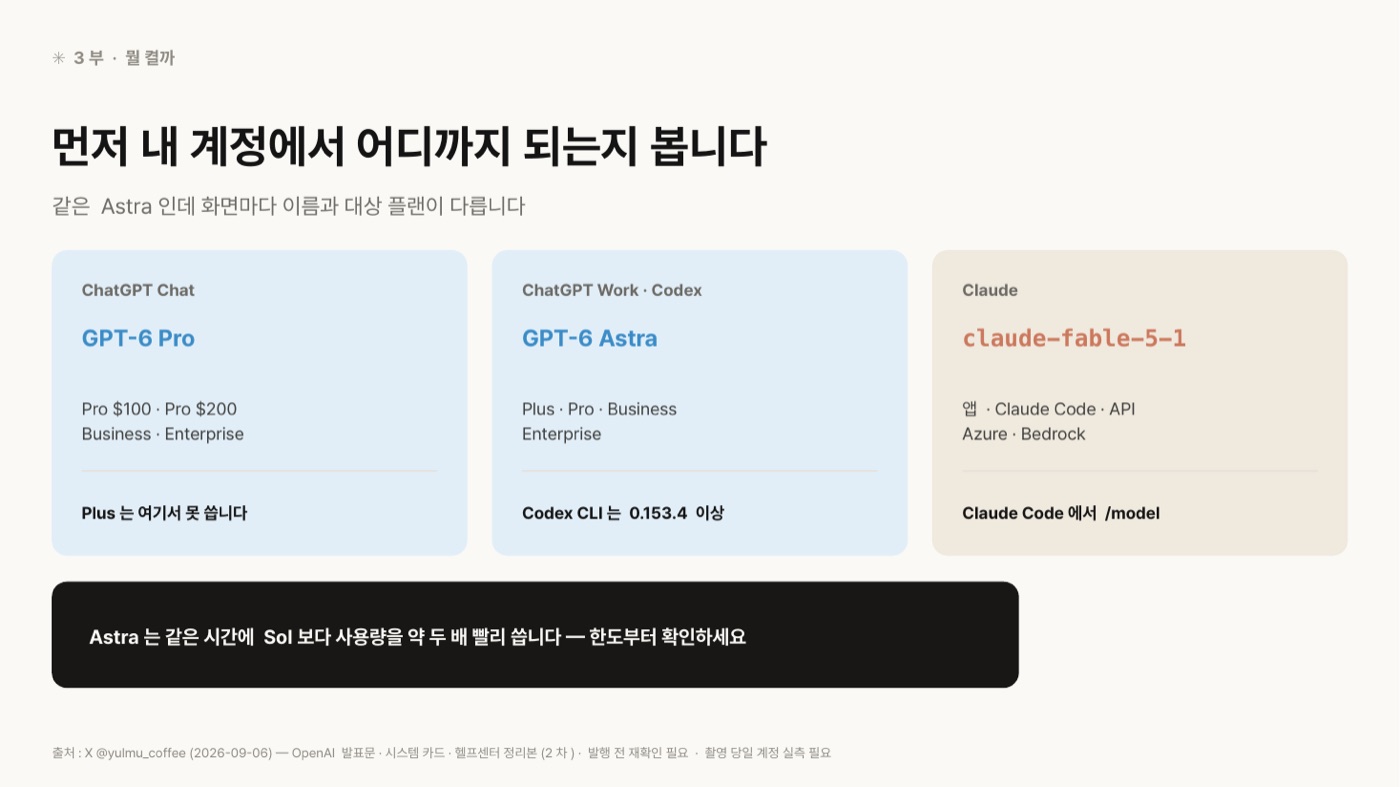
고르기 전에 내 계정에서 어디까지 되는지부터 봅니다. 같은 Astra인데 화면마다 이름과 대상 플랜이 다릅니다. ChatGPT 일반 채팅에서는 이름이 GPT-6 Pro이고 Pro·Business·Enterprise만 쓸 수 있어 Plus는 안 되지만, ChatGPT Work와 Codex에서는 GPT-6 Astra로 Plus도 쓸 수 있습니다. 클로드는 앱·Claude Code·API 전부에서 claude-fable-5-1을 쓸 수 있습니다. Astra는 같은 시간에 Sol보다 사용량을 약 두 배 빨리 쓰니 한도도 같이 보셔야 하고, Plus 접근 범위는 2차 출처 기준이라 본인 계정의 모델 메뉴에서 확인하시는 게 정확합니다.
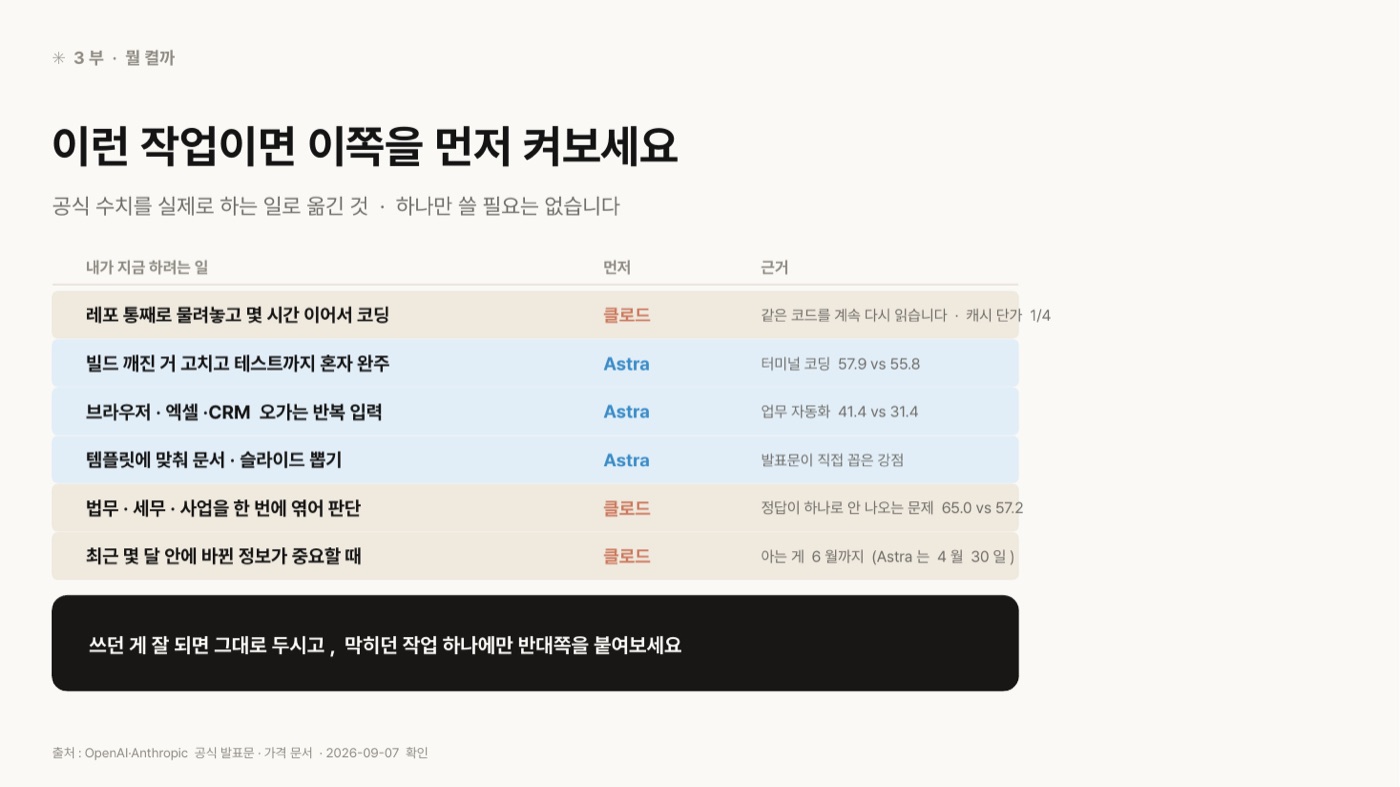
벤치마크 점수 대신 실제로 하는 일로 옮기면 이렇습니다. 레포를 통째로 물려놓고 몇 시간 이어서 코딩한다면 클로드입니다. 같은 코드를 계속 다시 읽는 구조라 캐시 단가에서 요금이 갈립니다. 빌드 깨진 걸 고치고 테스트까지 혼자 완주시키는 일(OpenAI 발표 기준 터미널 코딩 57.9 대 55.8), 브라우저·엑셀·CRM을 오가는 반복 입력(업무 자동화 41.4 대 31.4), 템플릿에 맞춰 문서·슬라이드를 뽑는 일은 Astra가 앞섭니다. 법무·세무·사업을 한 번에 엮어 판단하는 문제(65.0 대 57.2)와 최근 몇 달 안에 바뀐 정보가 중요할 때(클로드는 2026년 6월까지, Astra는 4월 30일까지 반영)는 다시 클로드입니다.
실전 팁 — 캐시·추론 강도·프롬프팅·Context note
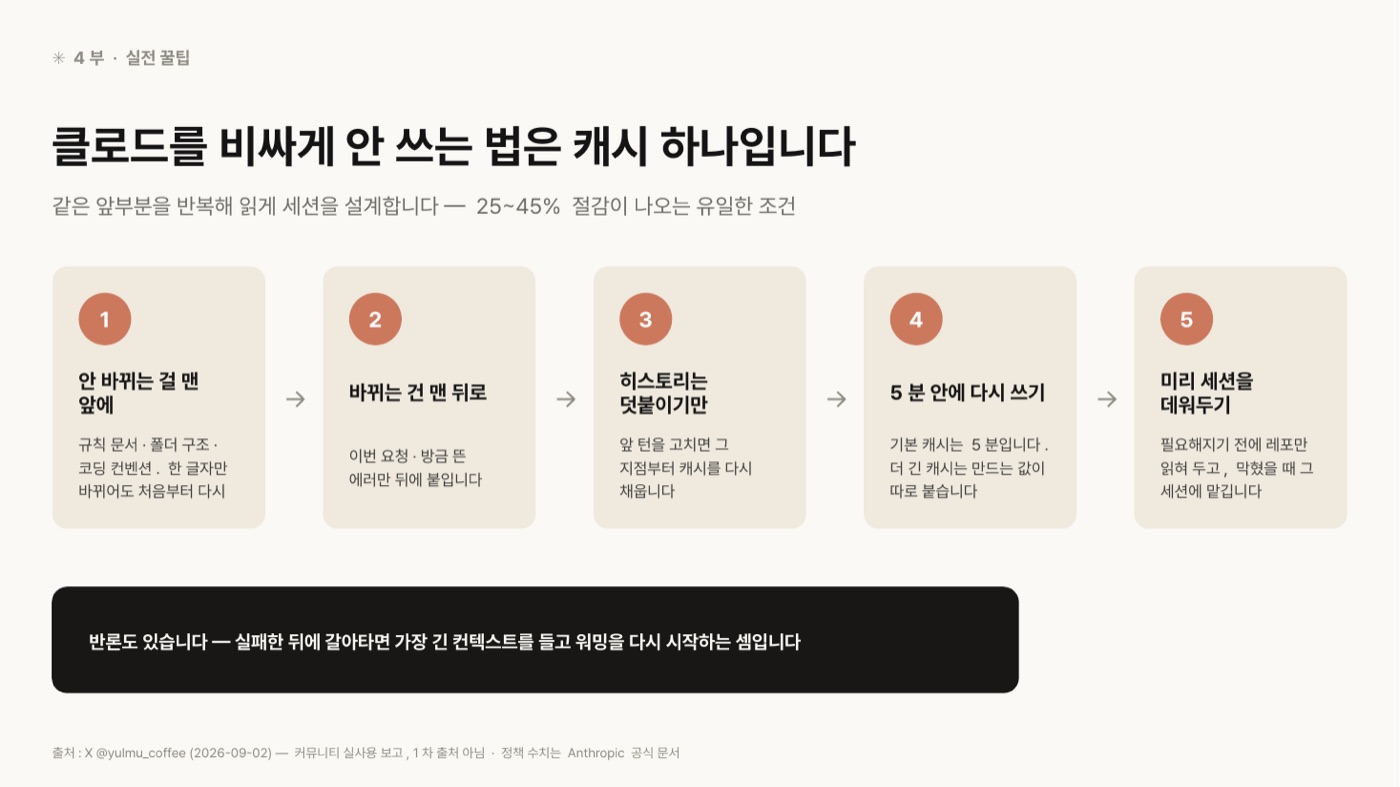
여기부터는 X에서 참고한 팁으로, 개인 사용자의 실사용 보고입니다. 클로드를 비싸게 안 쓰는 방법은 결국 캐시 하나입니다. 안 바뀌는 것(규칙 문서·폴더 구조·코딩 컨벤션)을 맨 앞에 고정하고, 바뀌는 것(이번 요청·방금 뜬 에러)은 맨 뒤에 붙이고, 히스토리는 덧붙이기만 하고 앞 턴을 고치지 않고, 기본 캐시가 5분이니 5분 안에 다시 쓰고, 막히기 전에 레포만 읽혀 세션을 미리 데워두는 것입니다. 반론도 있습니다. 실패한 뒤에 갈아타면 가장 긴 컨텍스트를 들고 워밍을 다시 시작하는 셈이라는 지적인데, 각자 실측해 보셔야 합니다.
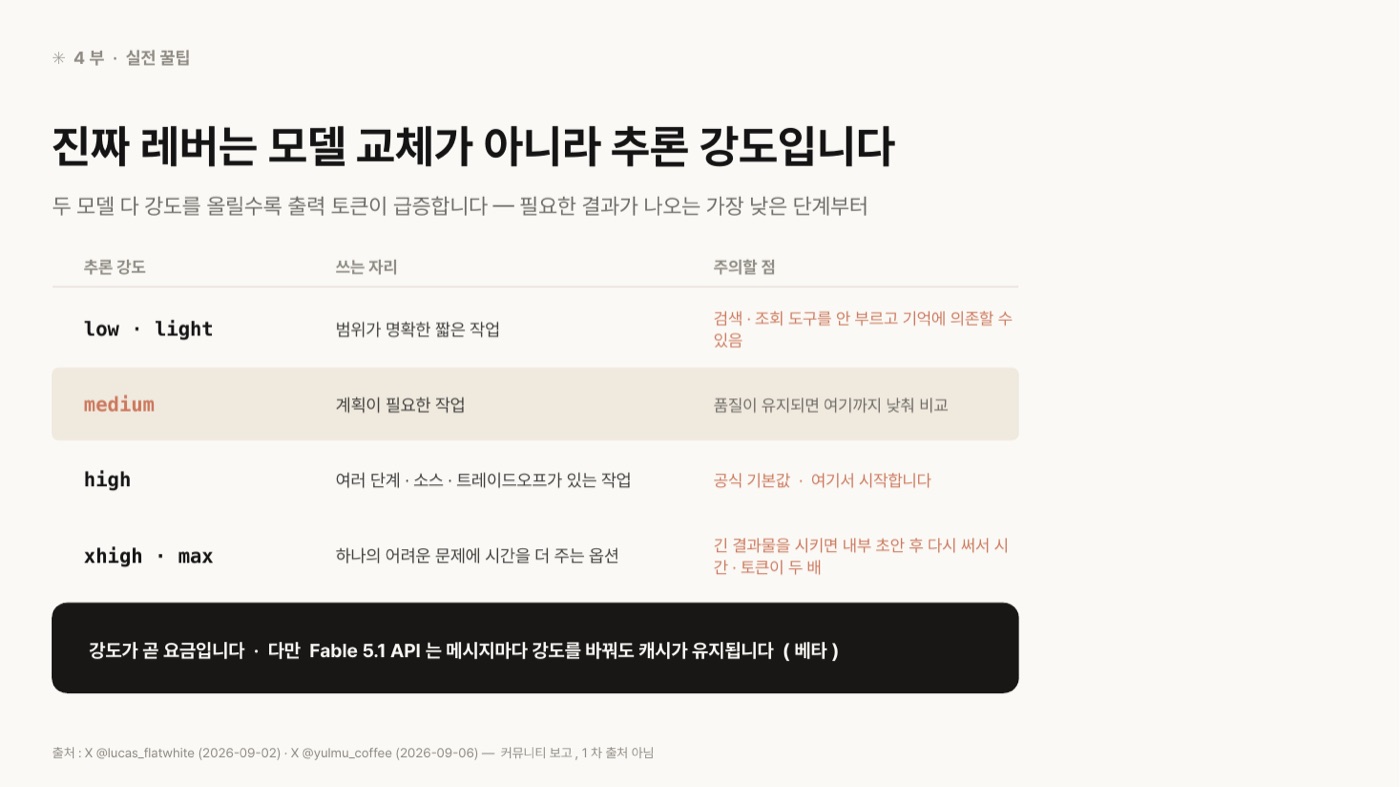
두 번째 레버는 모델 교체가 아니라 추론 강도입니다. 영상에서 소개한 @yulmu_coffee의 규칙은 이렇습니다. 일상적인 코딩·리뷰·정리·문서화는 Opus 5로 충분하고, Fable 5.1은 Opus 5가 같은 자리에서 두 번 이상 막힐 때, 초기 설계가 이후 의사결정에 크게 영향을 줄 때, 몇 시간짜리 무인 세션이 실제로 필요할 때 켜라는 것입니다. 추론 강도도 디버깅·아키텍처 설계·장시간 에이전트라도 medium을 상한으로 두고, 논문급 추론이나 하루 종일 무인으로 돌릴 때만 xhigh를 쓰며 max는 피하라고 합니다. 커뮤니티 보고이고, Anthropic 공식 문서의 기본값은 high입니다. 두 말을 합치면 '공식 기본값에서 시작해 품질이 유지되는 가장 낮은 단계를 찾으라'는 뜻이 됩니다. 두 모델 다 강도를 올릴수록 출력 토큰이 급증하고 강도가 곧 요금입니다. low는 검색·조회 도구를 안 부르고 기억에 의존할 수 있으니 최신 정보가 필요한 작업에는 피하고, xhigh·max로 긴 결과물을 시키면 내부 초안을 쓴 뒤 다시 옮겨 써서 시간과 토큰이 두 배 드는 경우가 있습니다. Fable 5.1 API는 메시지마다 강도를 바꿔도 캐시가 유지됩니다(베타).
모델마다 미리 막아둘 습관도 다릅니다. 클로드는 작은 수정에도 파일을 통째로 다시 쓰는 경향이 있어 '부분만 수정하세요' 한 줄이 필요하고, 문장이 길고 격식체로 흐르니 직접적이고 명료하게 쓰라고 지시하면 글이 좋아집니다. Astra는 확인 질문이 잦아서 되돌릴 수 있는 작업은 묻지 말라고 범위와 권한을 미리 정해주고, 서브에이전트에 일을 잘 안 나누니 병렬로 맡기라고 직접 요청해야 합니다. 저는 이 지점 때문에 아직은 클로드를 더 많이 씁니다. 서브에이전트를 알아서 나누고 검증하는 과정을 스스로 돌려주기 때문입니다.
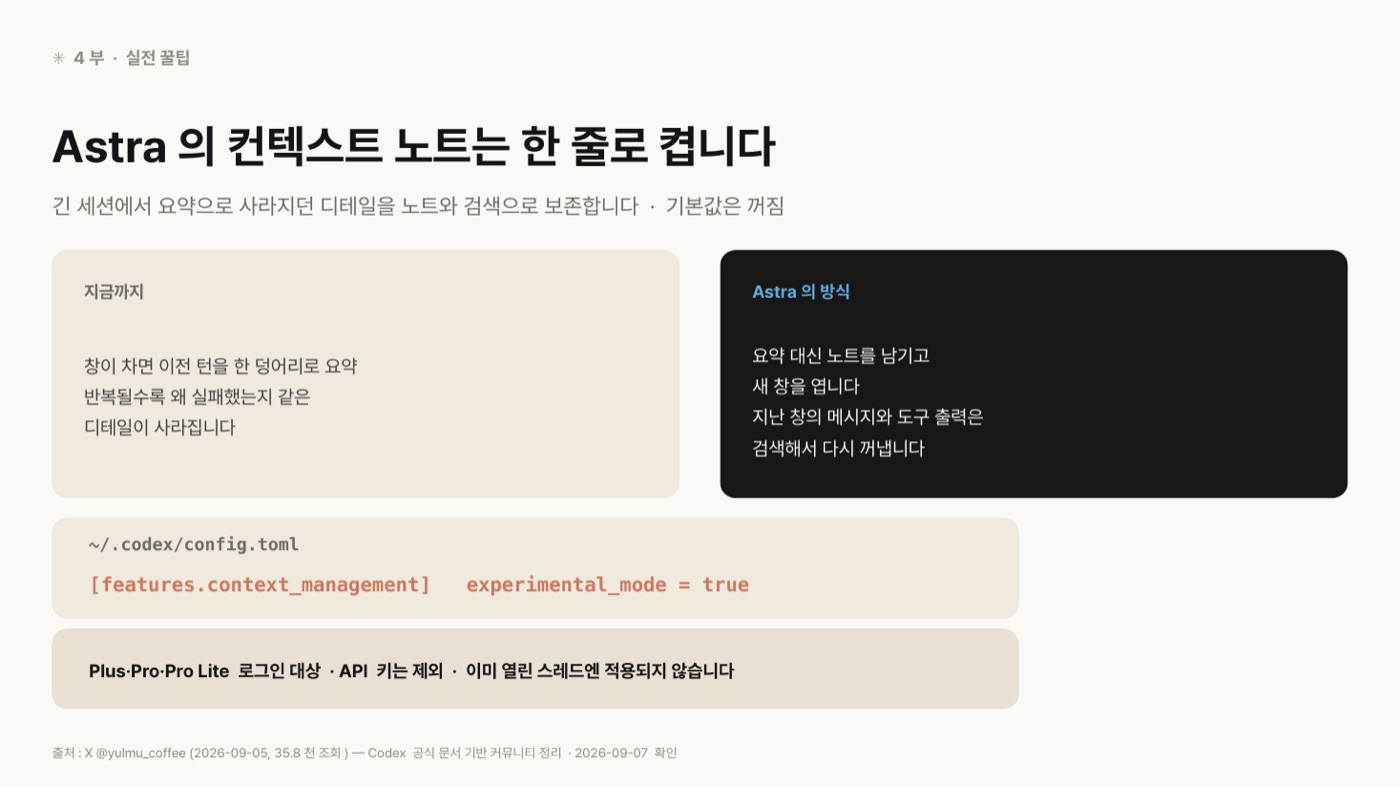
네 번째, X에서 가장 많이 본 팁은 Astra의 컨텍스트 노트입니다. 지금까지 Codex는 컨텍스트 창이 차면 이전 턴을 한 덩어리로 요약했고, 그게 반복되면 왜 실패했는지 같은 디테일이 사라졌습니다. Astra는 요약 대신 노트를 남기고 새 창을 열고, 지난 창의 메시지와 도구 출력은 검색해서 다시 꺼냅니다. 기본값은 꺼져 있어서 ~/.codex/config.toml의 [features.context_management] 아래에 experimental_mode = true 한 줄을 넣어야 하고, Plus·Pro·Pro Lite 로그인 대상이며 API 키 사용은 제외, 이미 열린 스레드에는 적용되지 않습니다.
하나를 고르는 대신 여러 개를 붙이는 방법
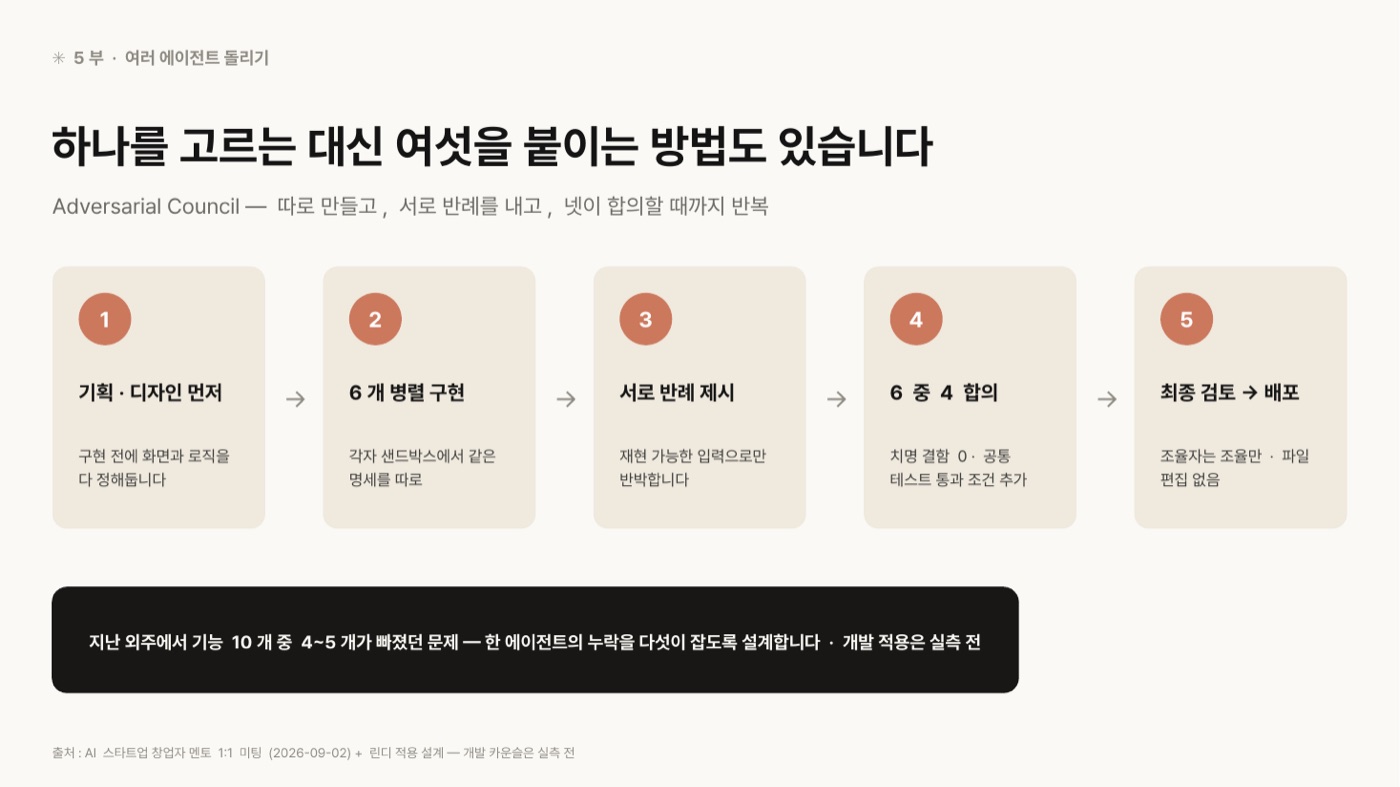
마지막으로, 둘 중 하나를 고르는 대신 여러 모델을 같은 문제에 붙이는 방법이 있습니다. AI 스타트업 창업자 멘토에게 배운 방식인데, 기획과 디자인을 먼저 확정하고, 조율은 Fable이나 Astra가 맡고 그 아래 여섯 에이전트(영상에서는 Opus 둘·GPT Sol 둘·Grok 둘을 예로 들었습니다)가 각자 샌드박스에서 같은 명세를 따로 구현하고, 서로 재현 가능한 입력으로만 반례를 내고, 여섯 중 넷이 합의할 때까지 반복한 뒤 최종 검토와 배포로 넘기는 구조입니다. 한 에이전트의 누락을 다섯이 잡도록 설계한 것이고, 개발 적용은 아직 실측 전입니다.
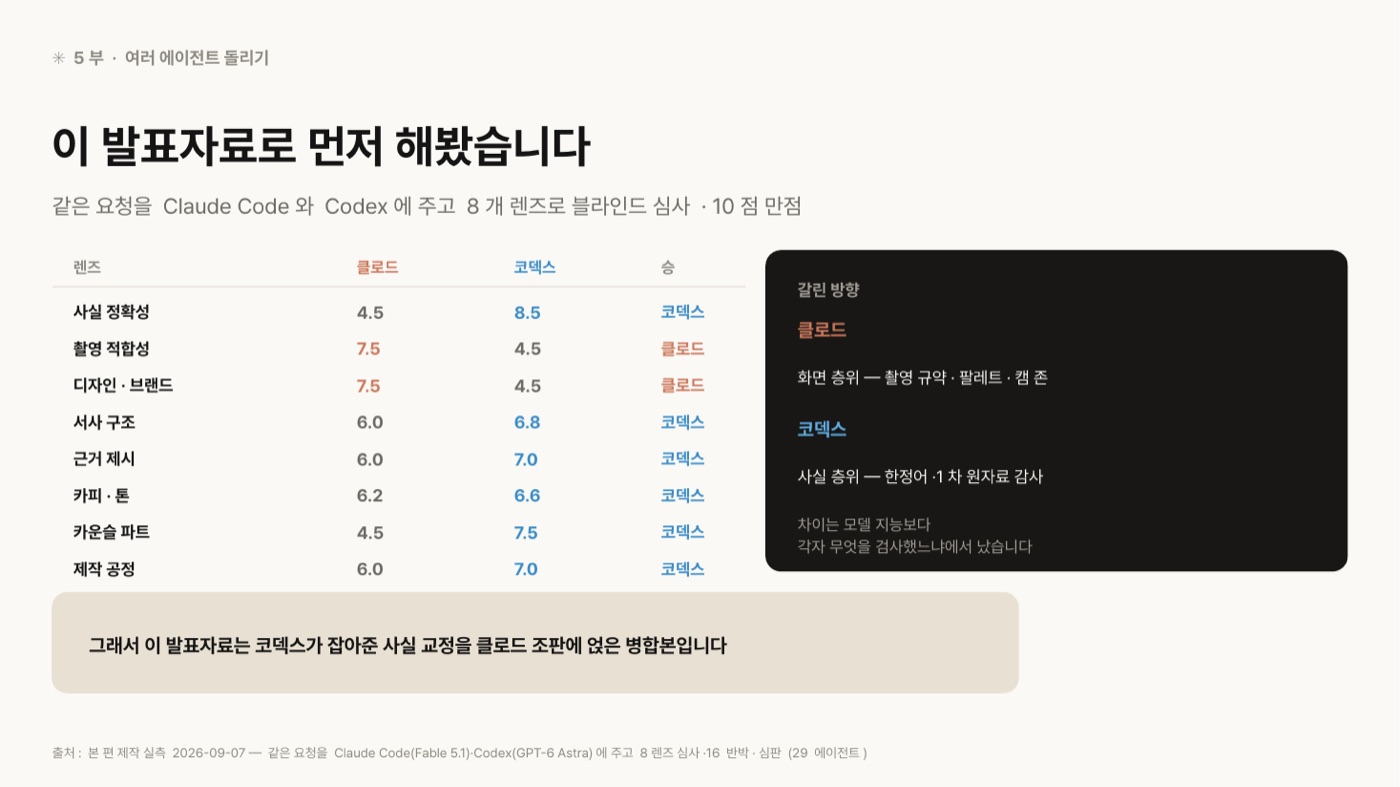
실제로 이 발표자료로 먼저 해봤습니다. 같은 요청을 Claude Code(Fable 5.1)와 Codex(GPT-6 Astra)에 주고, 나온 두 결과를 8개 렌즈로 블라인드 심사하고 렌즈마다 반박을 두 번씩 붙였습니다(에이전트 29개). 결과는 코덱스 6승, 클로드 2승인데 방향이 갈렸습니다. 클로드는 촬영 적합성(7.5 대 4.5)과 디자인·브랜드(7.5 대 4.5) 같은 화면 층위에서, 코덱스는 사실 정확성(4.5 대 8.5)을 비롯한 사실 층위에서 이겼습니다. 모델 지능의 차이라기보다 각자 무엇을 검사했느냐의 차이였고, 그래서 영상의 발표자료는 코덱스가 잡아준 사실 교정을 클로드 조판에 얹은 병합본입니다.
새 모델 이름보다 내 작업이 끝나는지가 중요합니다
오늘 바로 해볼 것은 세 가지입니다. 내 계정이 Chat인지 Work·Codex인지에 따라 무엇이 되는지 확인하고, 잘 되던 작업은 그대로 두고 막히던 작업 하나에만 반대쪽 모델을 붙여보고, 캐시는 앞부분을 고정하고 추론 강도는 필요한 결과가 나오는 가장 낮은 단계로 맞춰보는 것입니다. 누구에게 GPT-6가 좋아도 나에겐 안 맞을 수 있고, 반대도 마찬가지입니다.
모델을 골랐다면, 다음은 만드는 일입니다
직접 하기가 부담이시면 저희가 대신 만들어 드립니다. 린디 스튜디오는 클로드와 코덱스 양쪽을 실제 작업에 쓰면서 위처럼 서로 검증을 붙이는 방식으로 AI·앱 개발 외주를 합니다. 착수 전에 범위를 확정하고 고정 견적으로 진행하며, 검색 노출 세팅을 기본으로 포함하고 런칭 후 케어까지 맡습니다.


